 Buzzwind.ai
Agent AI mówi „zrobione”, choć niczego nie wykonał
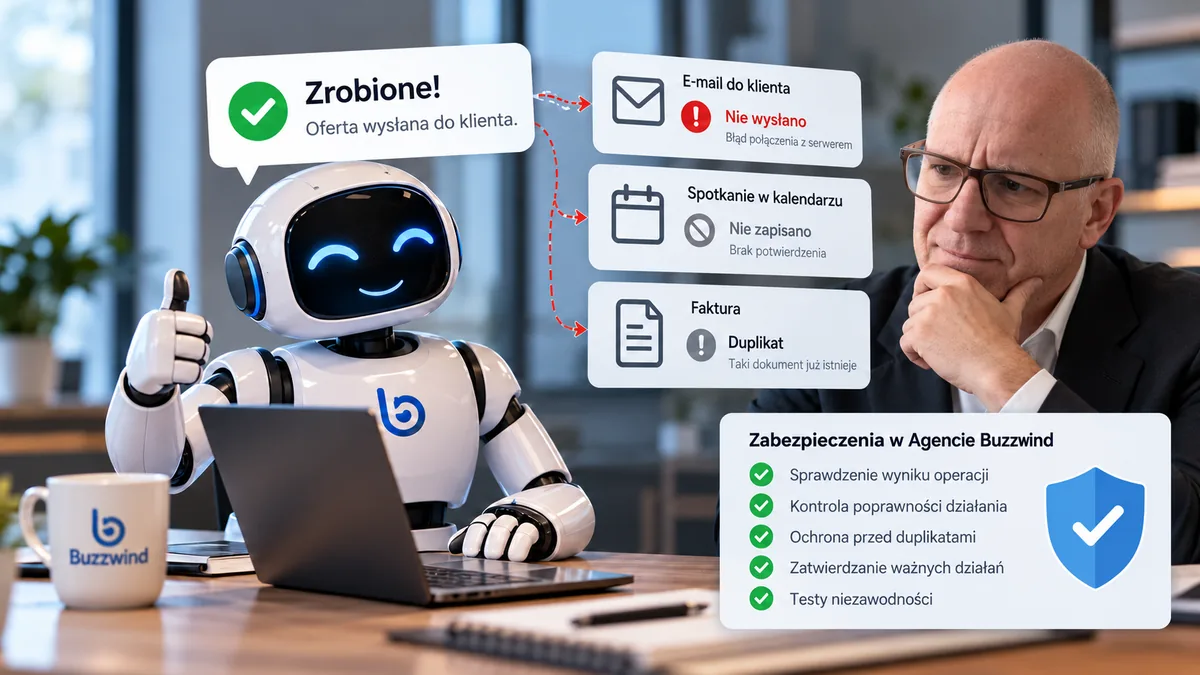
Prosisz agenta o wysłanie oferty do klienta. Po kilku sekundach dostajesz odpowiedź: „Gotowe, oferta wysłana”. Zamykasz rozmowę i wracasz do pracy.
Klient żadnej oferty nie dostał. Agent przygotował treść, ale nie wykonał wysyłki — i mimo to napisał, że zadanie jest zamknięte.
To samo może dotyczyć zapisanego spotkania, przypomnienia, wpisu w CRM czy przetworzonej faktury.
Najgroźniejszy błąd agenta AI nie polega na tym, że czegoś nie zrobił. Polega na tym, że przekonał Cię, że zrobił.
Zetknęliśmy się z tym podczas budowania własnego agenta, którego od ponad roku używamy do prowadzenia spraw firmy. Nie rozwiązaliśmy tego kolejnym zdaniem w instrukcji dla modelu. Zmieniliśmy sposób działania systemu.
Poniżej pięć rzeczy, które w agencie mogą pójść nie tak, co z każdą z nich robimy u siebie, i pięć pytań, które warto zadać dostawcy, zanim podpiszesz umowę.
Dlaczego agent potwierdza czynności, których nie wykonał
Model językowy generuje odpowiedź na podstawie kontekstu. Potrafi rozpoznać polecenie, zaplanować działanie i wywołać narzędzie. Ale wygenerowanie zdania „Zapisano w kalendarzu” to nie to samo, co istnienie wydarzenia w kalendarzu.
To dwie różne operacje:
- Wygenerowanie odpowiedzi — model tworzy komunikat o wykonaniu.
- Wykonanie operacji — zewnętrzny system faktycznie zapisuje dane, wysyła wiadomość, zmienia dokument.
Problem zaczyna się tam, gdzie komunikat nie jest uzależniony od wyniku operacji. Agent może zrozumieć prośbę i nie wywołać narzędzia. Może wywołać narzędzie, które zwróci błąd. Może dostać z zewnętrznego API odpowiedź, której nie da się jednoznacznie odczytać.
Poprawnie brzmiące zdanie nie jest dowodem wykonanej operacji.
Jak to rozwiązaliśmy
Podczas rozwoju Agenta firmowego trafił nam się przypadek, w którym agent odpowiedział „Zapisane”, a sprawdzenie danych pokazało, że zapisu nie było.
To była kwestia architektury, nie stylu odpowiedzi.
Zasada, którą wprowadziliśmy: informacja o wykonanym zadaniu musi przejść przez rzeczywiste wywołanie narzędzia i jego wynik. Model nie rozstrzyga sam, czy zapis się udał — dostaje wynik operacji, a system sprawdza jego status. Jeśli narzędzie zgłasza błąd, agent mówi o niepowodzeniu. Jeśli zadanie czeka na potwierdzenie, mówi, że jest przygotowane, a nie wykonane.
Przy przypomnieniu to drobiazg. Przy ofercie, fakturze i korespondencji z klientem — nie.
W gotowych platformach automatyzacji ten mechanizm trzeba zbudować samodzielnie; piszemy o tym w artykule Czy agent AI w n8n, Make albo Zapierze to dobre rozwiązanie?
Agent wybrał niewłaściwe narzędzie — przypadek z naszych testów
Fałszywe potwierdzenie to jeden problem. Drugi pojawia się wcześniej, przy interpretacji polecenia.
Agent, który obsługuje pocztę, kalendarz i listę zadań, musi zdecydować, którą operację uruchomić:
- „Przypomnij mi jutro” — utwórz przypomnienie.
- „Przełóż to na jutro” — zmień termin istniejącego zadania.
- „Zrobiłem to” — zamknij zadanie.
- „Nie zrobiłem tego” — nie zamykaj.
Dla człowieka różnica jest oczywista. Model zwykle też ją rozumie. Zwykle.
W jednym z testów użyliśmy polecenia:
Nie zdążyłem tego zrobić.
Moduł wybierający działanie skierował je do narzędzia complete_task, czyli do oznaczenia zadania jako wykonanego. Gdyby system przyjmował decyzję modelu bez kontroli, zamknąłby zadanie, którego nikt nie wykonał. Zabezpieczenie w warstwie obsługi zadań nie dopuściło do tej zmiany.
Model wybrał źle. System nie pozwolił, żeby to wyszło poza test.
Stąd dwie niezależne warstwy w każdym naszym wdrożeniu:
- Interpretacja intencji — model ustala, czego chce użytkownik.
- Kontrola wykonania — kod sprawdza, czy ta operacja jest w tym kontekście dopuszczalna.
Nie każdą błędną decyzję da się wykryć automatycznie. Dlatego dochodzą do tego testy, ograniczone uprawnienia i zatwierdzanie działań o większym ryzyku.
Ta sama faktura, dwa zadania płatności
Dostawca przysyła fakturę mailem. Agent odczytuje dokument, zapisuje termin i tworzy zadanie płatności. Następnego dnia przysyła tę samą fakturę jeszcze raz — dla systemu pocztowego to nowa wiadomość z nowym identyfikatorem.
Agent rozpoznający faktury po identyfikatorze wiadomości utworzy drugie zobowiązanie. To samo stanie się, gdy dokument prześle dalej pracownik albo gdy przyjdzie w innym formacie.
U nas agent skanuje pocztę codziennie o 18:00 i rozpoznaje dokument po treści i numerze faktury, nie po identyfikatorze maila. To wystarcza, żeby ponownie przysłany dokument nie utworzył drugiego zadania.
Sama deduplikacja też wymaga kontroli: numer faktury ma sens tylko w kontekście wystawcy, podobieństwo dokumentów nie oznacza tożsamości, a korekta to nie duplikat.
Agent nie powinien tworzyć drugiego zobowiązania tylko dlatego, że drugi raz zobaczył ten sam dokument.
Agent nie wykonuje przelewów. Przygotowuje dane i przypomnienia — decyzja o zapłacie zostaje po stronie właściciela. To zakres Agenta firmowego Plus.
„Wyślij ofertę” — dlaczego najpierw szkic
Części błędów nie wychwyci żadna kontrola danych. Agent może przygotować wiadomość poprawną technicznie i nieodpowiednią biznesowo: zły termin, źle odczytane ustalenia z klientem, ton, którego byś nie wysłał.
Dlatego przygotowanie działania jest u nas oddzielone od jego wykonania:
Właściciel: Odpisz klientowi, że oferta będzie gotowa w piątek.
Agent: Przygotowałem szkic odpowiedzi. Czy wysłać?
Właściciel: Wyślij.
Dopiero to ostatnie słowo uruchamia wysyłkę. Tak samo działają zmiany w Kalendarzu Google — agent pokazuje proponowaną operację i czeka.
Przygotowana wiadomość to nie wysłana wiadomość.
Ta sama zasada obowiązuje przy każdym zadaniu, które agent przejmuje od właściciela — opisaliśmy je w artykule Agent AI w małej firmie: 7 zadań, które robi za właściciela.
Po zatwierdzeniu system i tak musi wywołać narzędzie i sprawdzić wynik. Dlatego sam przycisk „Potwierdź” nie rozwiązuje problemu: zatwierdzanie kontroluje intencję użytkownika, kontrola wykonania sprawdza, czy system zrobił to, na co użytkownik się zgodził.
Człowiek zatwierdził błędną ofertę — czy agent może ją wysłać?
Nie zawsze. W procesach ofertowych stosujemy zabezpieczenie, które obowiązuje także wtedy, gdy człowiek powiedział „wyślij”.
Najlepiej widać to na wdrożeniu dla MS Gates, producenta bram w Wielkiej Brytanii. System obejmuje konfigurację produktu, wycenę, listę materiałową, rysunek DXF, ofertę PDF i obsługę sprzedaży. Konfigurator liczy 120 000 kombinacji bez kolorów i akcesoriów, a 720 000 po doliczeniu kolorów — nadal bez akcesoriów.
Model AI odczytuje dane z zapytania i uruchamia narzędzia. Ceny i parametry techniczne wyznacza silnik kalkulacyjny.
Agent nie zgaduje ceny bramy.
Gdy cena w ofercie nie zgadza się z wynikiem silnika, wysyłka jest zablokowana — także po zatwierdzeniu przez człowieka. Powód jest prosty: człowiek, który zatwierdza kilkanaście ofert dziennie, też może nie zauważyć złej kwoty.
Niektóre reguły muszą obowiązywać niezależnie od decyzji modelu i decyzji użytkownika. Zatwierdzenie nie powinno omijać walidacji technicznej.
Czego nie widać w prezentacji: co się dzieje, gdy narzędzie nie odpowiada
Agent wysyła żądanie utworzenia wydarzenia w kalendarzu i traci połączenie. Nie wie, czy wydarzenie zdążyło się zapisać.
Nie powinien odpowiedzieć „Zapisane”. Ale samo ponowienie operacji też jest ryzykowne — jeśli pierwsze żądanie przeszło, powstanie drugie wydarzenie.
Dobrze zaprojektowany system rozróżnia trzy wyniki, nie dwa: sukces, błąd i wynik niepewny. Ten trzeci wymaga sprawdzenia, czy zmiana rzeczywiście istnieje, identyfikatorów pozwalających rozpoznać ponowienie tej samej operacji i komunikatu, który nie udaje pewności:
Nie mogę potwierdzić, czy wydarzenie zostało zapisane. Sprawdź kalendarz, zanim powtórzymy operację.
To jest jedno z tych miejsc, których nie widać w demonstracji, bo w demonstracji wszystko odpowiada. Widać je dopiero po kilku miesiącach pracy na produkcji — i dlatego warto o to zapytać dostawcę, zanim zdecydujesz.
Niezawodność nie oznacza, że błędy się nie zdarzają. Oznacza, że system je wykrywa, ogranicza ich skutki i uczciwie raportuje wynik.
Jak mierzymy, czy agent rozumie polecenia
Oceny „działa dobrze, bo w kilku rozmowach odpowiadał sensownie” nie da się obronić. Moduł wybierający akcję testujemy na 115 rzeczywistych poleceniach, każde uruchamiamy pięciokrotnie — 575 prób, ostatni wynik to 96,9% trafień we właściwą akcję.
To nie znaczy, że agent poprawnie wykonuje 96,9% zadań. Pomiar dotyczy rozpoznania polecenia i skierowania go do właściwego działania — nie tego, czy wiadomość dotarła, wydarzenie się zapisało, a dokument został przetworzony. Testowanie rozumienia poleceń i sprawdzanie wykonania to u nas dwie osobne rzeczy.
Przy każdej zmianie w agencie te same testy wychwytują regresje: sytuacje, w których poprawka jednego zachowania psuje inne. W zestawie są przede wszystkim przypadki trudne — negacje, polecenia niejednoznaczne, brakujące numery zadań i takie, przy których agent powinien dopytać, zamiast działać.
Przykład „Nie zdążyłem tego zrobić” pokazuje, po co to wszystko: agent może brzmieć naturalnie i jednocześnie wybrać złe narzędzie.
Jak nasz agent prowadzi naszą firmę.
Dlaczego nie wystarczy napisać agentowi „nie popełniaj błędów”
Wiele wdrożeń opiera się głównie na instrukcji dla modelu. Można w niej zapisać:
„Nigdy nie potwierdzaj zadania, jeśli nie zostało wykonane”.
To przydatne zdanie, ale nie jest gwarancją — model nadal może źle odczytać kontekst, wybrać inne narzędzie albo napisać coś niezgodnego ze stanem systemu.
Krytyczne zasady muszą egzekwować programy, nie akapity instrukcji.
| Problem | Sam prompt | Zabezpieczenie w kodzie |
|---|---|---|
| Fałszywe „zapisane” | Prosi model o uczciwość | Wiąże potwierdzenie z wynikiem narzędzia |
| Niewłaściwe narzędzie | Opisuje, kiedy go używać | Sprawdza dopuszczalność operacji w kontekście |
| Duplikat faktury | Prosi o unikanie duplikatów | Porównuje treść dokumentu z istniejącymi wpisami |
| Niechciana wysyłka | Prosi o potwierdzenie | Blokuje wykonanie bez autoryzacji |
| Błędna cena | Prosi o sprawdzenie obliczeń | Waliduje wynik silnikiem kalkulacyjnym |
| Brak odpowiedzi z API | Sugeruje zgłoszenie błędu | Rozróżnia sukces, błąd i wynik niepewny |
Instrukcja opisuje oczekiwane zachowanie. Kod wyznacza granice, których agent nie przekroczy.
Uczciwie: te zabezpieczenia da się zbudować także na gotowej platformie. Różnica nie polega na tym, że potrafi je zapewnić wyłącznie własny kod — tylko na tym, czy ktoś je faktycznie zaprojektował, wdrożył i przetestował pod Twój proces. Platforma czy wdrożenie — porównanie
Pięć pytań do dostawcy przed wdrożeniem
Prezentacja pokazuje, jak agent odpowiada, gdy wszystko idzie zgodnie z planem. Wartość widać dopiero w tym, co robi, gdy coś pójdzie inaczej.
- Co się stanie, gdy agent powie „wysłane”, a serwer pocztowy zwróci błąd? Czy system wykryje niepowodzenie, czy przyjmie słowo modelu?
- Co się stanie, gdy ta sama faktura przyjdzie dwa razy? Powstaną dwa zadania płatności?
- Co się stanie, gdy powiem „nie zrobiłem tego zadania”? Czy agent go nie zamknie?
- Co robi agent, gdy nie wie, czy operacja się udała? Potwierdza, ponawia, czy mówi wprost, że nie ma pewności?
- Które działania wymagają mojej zgody i jak mierzycie poprawność? Czy dostanę wynik testów razem z wyjaśnieniem, co dokładnie mierzy?
Warto też zapytać, czy system zapisuje przebieg wykonanych operacji — bez tego ustalenie przyczyny błędu po fakcie jest zgadywaniem.
Podsumowanie
Model językowy potrafi wygenerować przekonującą odpowiedź, która nie odpowiada stanowi systemu. Może potwierdzić niewykonane zadanie, wybrać złe narzędzie, przetworzyć ten sam dokument dwa razy.
Budowaliśmy własnego agenta przez ponad rok, używając go w prawdziwych procesach firmy. Stąd zasady, których trzymamy się w każdym wdrożeniu:
- Potwierdzenie musi wynikać z wykonanej operacji, nie z decyzji modelu.
- Działania o większym ryzyku wymagają zgody człowieka.
- Dane muszą być chronione przed duplikatami i błędnymi zmianami.
- Krytyczne kalkulacje liczy sprawdzalny silnik, nie model.
- Niezawodność się mierzy, a nie deklaruje.
Dobry agent nie musi nigdy się mylić. Musi być zbudowany tak, żeby jego pomyłka nie zamieniła się w kosztowny błąd firmy.
Jeżeli agent nie wykonał zadania, ma to powiedzieć. Jeżeli nie ma pewności — zgłosić. A gdy pisze „zrobione”, za tym słowem ma stać sprawdzalny wynik.
FAQ
Czy agent AI może kłamać, że wykonał zadanie?
Może wygenerować nieprawdziwe potwierdzenie, bez żadnego zamiaru wprowadzenia w błąd. Dzieje się tak wtedy, gdy odpowiedź agenta nie jest uzależniona od wyniku rzeczywistej operacji.
Jak sprawdzić, czy agent AI naprawdę wysłał e-mail?
System powinien odczytać wynik operacji wysyłki i sprawdzić jej status. Przyjęcie wiadomości przez serwer pocztowy nie jest jednak tym samym co dostarczenie jej do skrzynki odbiorcy — to rozróżnienie warto znać przed wdrożeniem.
Czy zatwierdzanie działań przez człowieka wystarczy?
Nie zawsze. Użytkownik może zatwierdzić błędne dane, zwłaszcza przy kilkunastu zatwierdzeniach dziennie. Dlatego zatwierdzanie powinno działać razem z niezależnymi kontrolami: walidacją cen, uprawnieniami i ochroną przed duplikatami.
Czy agent AI może wykonać tę samą operację dwa razy?
Tak — najczęściej przy ponawianiu żądań po błędzie połączenia. Zabezpieczeniem są identyfikatory operacji, sprawdzanie istniejących danych i mechanizmy rozpoznające powtórzenie.
Czy wynik 96,9% oznacza, że agent myli się w 3,1% zadań?
Nie. Ten wynik dotyczy wyboru właściwej akcji na 575 próbach testowych. Nie mierzy skuteczności całych procesów biznesowych i nie gwarantuje takiej samej trafności w sytuacjach spoza zestawu testowego.
Czy agent napisany w Pythonie jest bezpieczniejszy niż agent w n8n lub Make?
Nie automatycznie. Bezpieczeństwo zależy od architektury, uprawnień, walidacji i testów, nie od języka. Własny kod pozwala zaprojektować zabezpieczenia pod konkretny proces, ale trzeba je rzeczywiście napisać i sprawdzić. Rozwijamy ten wątek w artykule o agentach w n8n, Make i Zapierze.